
артём шумейко
7 паттернов микросервисной архитектуры, которые стоит знать каждому разработчику
Senior Backend engineer
Ex-Самокат
19.10.2026

Представим, что мы разрабатываем сервис для прослушивания музыки — Пай.Музыку. В него уже заходит больше 100 тысяч пользователей в месяц, в команде работает 10+ инженеров, а недавно к музыке добавились подкасты и личный кабинет музыканта. Новые направления хочется часто обновлять и отдельно масштабировать (из-за разной нагрузки), основную логику — релизить пореже. Но пока всё живёт в одном монолите: общий релизный цикл тормозит команды, а изменения в одних и тех же файлах приводят к мерж-конфликтам.
Команда приняла решение распилить монолит на несколько микросервисов. Но вот незадача: почти никто не имел такого опыта, а о паттернах читали лишь в книжках. Давайте поможем команде внедрить нужные паттерны, заодно обсудив, какую проблему они решают и чем приходится платить за это.
В этой статье слова “сервис” и “микросервис” используются взаимозаменяемо.


Автор – Артём Шумейко, Senior Python Разработчик
Самокат
Senior Engineer
Разрабатывал платформу аналитики данных с ETL для всех бизнес-юнитов
FinTech (под NDA)
FullStack Developer
Разработал платформу мгновенного отображения торговых сделок с нагрузкой >5000 op/sec
Курс по FastAPI
Автор и наставник
Создал курс по FastAPI, победив в номинации «Прорыв года» на Stepik со средней оценкой 4.9
1. Strangler Fig — Переезжаем с монолита на микросервисы
Переписывать всё приложение за один заход мы не хотим, поэтому постепенно выносим из монолита отдельные части. Сначала подкасты, затем кабинет музыканта: соответствующие запросы монолит передаёт (проксирует) новым микросервисам, остальную логику продолжает выполнять сам. Маршрутизацию можно вынести и в отдельную прослойку перед ним, а перенос начинать с простых частей и постепенно переходить к сложным.
Так работает Strangler Fig. Название переводится как “фикус-душитель” — растение, которое разрастается вокруг дерева и со временем может его вытеснить. В нашем случае монолит тоже может полностью исчезнуть, после чего ненужную промежуточную прослойку можно убрать. Хотя иногда разработчики оставляют основную бизнес-логику в монолите, не избавляясь полностью от него — это нормально. На время переезда система станет сложнее: поддерживать придётся одновременно монолит и новые сервисы, поэтому такой переход имеет смысл, когда у разделения уже есть причина.
В коде это может выглядеть так: все запросы, начинающиеся с /podcasts-svc или /musician-svc будут перенаправляться по HTTP в соответствующие микросервисы, а все остальные запросы обрабатываться самим монолитом.
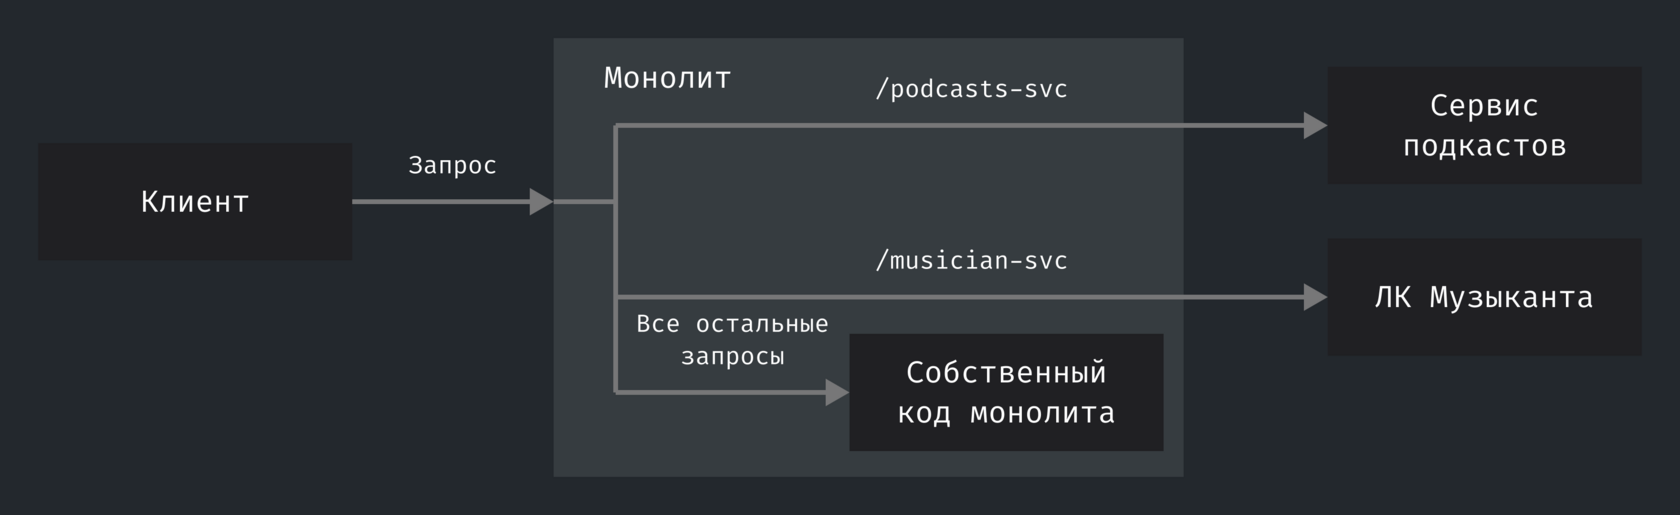
Промежуточный этап распила монолита на микросервисы: пока что жив старый монолит, но часть кода уже вынесена в отдельные микросервисы
ㅤ
2. API Gateway — Единая точка входа
Фух, вроде процесс пошел. После нескольких недель работы мы смогли избавиться от монолита. После разделения клиенту нужен способ обращаться к нашим сервисам. Можно дать клиенту (браузеру) адреса всех апишек: например, podcasts-api.py-music.ru, musician-api.py-music.ru. Клиент в таком случае четко понимает куда обращается. Но спустя пару недель с таким сетапом бэкендеры начали жаловаться: если раньше логика аутентификации, ограничения количества запросов по IP-адресу были на стороне монолита, теперь этот код повторяется в каждом микросервисе. Разработчикам и лиду бэкенда это показалось неудобным. В итоге решили добавить прослойку между клиентом и всеми сервисами, чтобы она сама занималась маршрутизацией, а также аутентификацией и рейт лимитингом. Такая прослойка называется API Gateway.
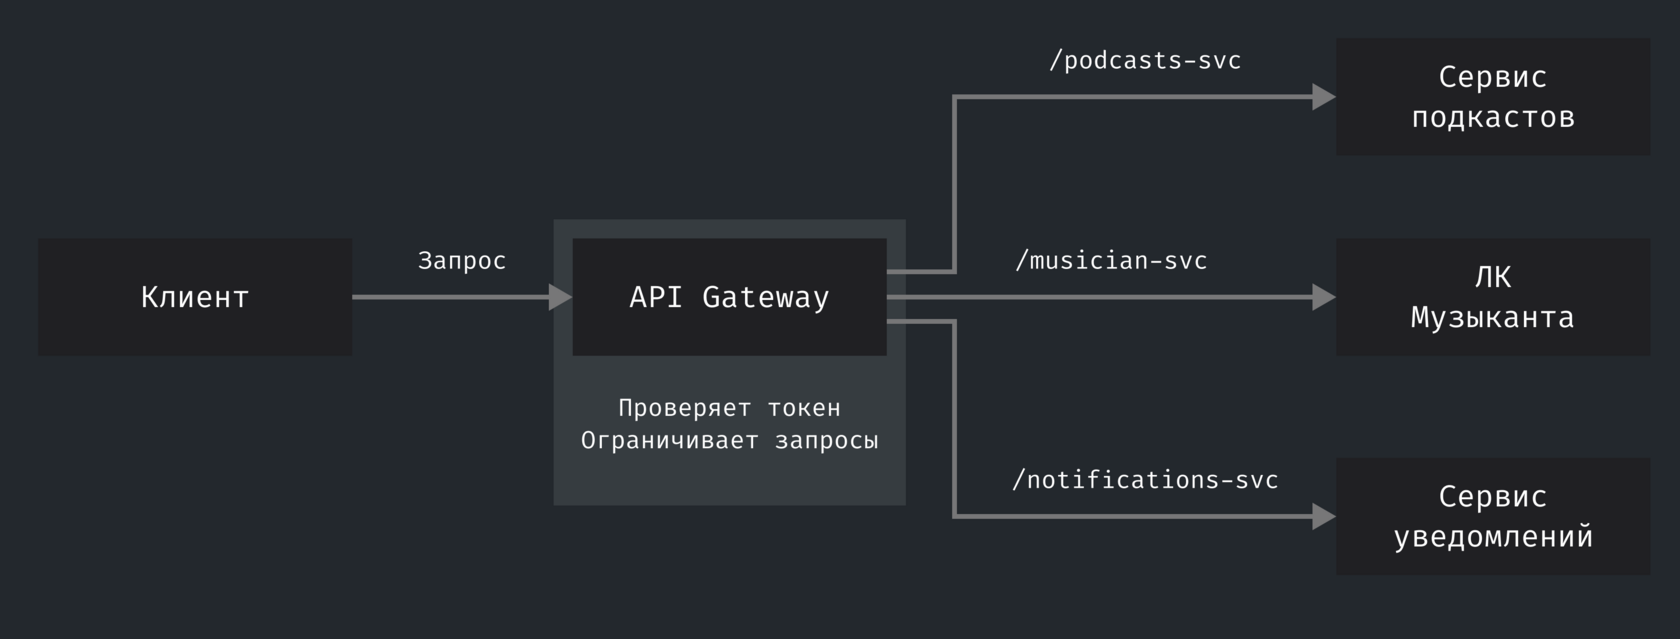
API Gateway даёт клиенту всего один адрес, например, gateway-api.py-music.ru и маршрутизирует внешний API-трафик: если запрос начинается с /podcasts-svc — перенаправляем запрос в сервис подкастов, /musician-svc — в кабинет музыканта, /notifications-svc — в сервис уведомлений и так далее.
Например, гейтвей получил запрос GET /podcasts-svc/podcasts/1. По префиксу он понимает, что нужно отправить запрос в сервис подкастов и делает запрос GET /podcasts/1, отбрасывая префикс (он нужен только для гейтвея).
Здесь же в API Gateway можно проверять токены и ограничивать количество запросов, чтобы один пользователь не отправлял миллион запросов в секунду. Проверка токена на входе при этом не отменяет проверку конкретных прав внутри сервисов.
Простейший Gateway можно написать на Python с FastAPI, но для полноценного проксирования придётся учитывать заголовки, потоковые ответы, WebSocket и другие нюансы. На практике часто берут готовые решения: Kong, Envoy или KrakenD, хотя для простой системы может хватить Nginx. Перед Gateway также обычно стоит реверс-прокси (тот же Nginx или Envoy) или балансировщик с частично пересекающимися функциями. Сам Gateway становится критически важной частью приложения, поэтому нужны несколько экземпляров и балансировка между ними, чтобы отказ одного не останавливал всю систему.
ㅤ
3. Database per Service — Каждому сервису по базе!
Сервисы мы разделили, но они всё ещё могут ходить в общую базу данных. Для небольшой системы это допустимо, однако представим, что сервис подкастов меняет таблицу выпусков, которую напрямую читают сервис музыки и кабинет музыканта. Снова приходится согласовывать изменения с другими командами, хотя мы хотели разрабатывать сервисы независимо.
То есть мы имеем проблему связности между сервисами. Хотя изначально хотели уйти от этого. Разработчики почесали головы и решились разделить соответствующие таблицы на разные базы данных, чтобы каждый сервис отвечал только за свою базу и не лез в чужие.
Паттерн Database per Service (каждому сервису – своя база данных) закрепляет данные за конкретным сервисом: только он напрямую читает и меняет свои таблицы, управляет схемой, миграциями и технологией хранения. Остальные получают данные через его API, например по HTTP, или через события в Kafka и RabbitMQ.
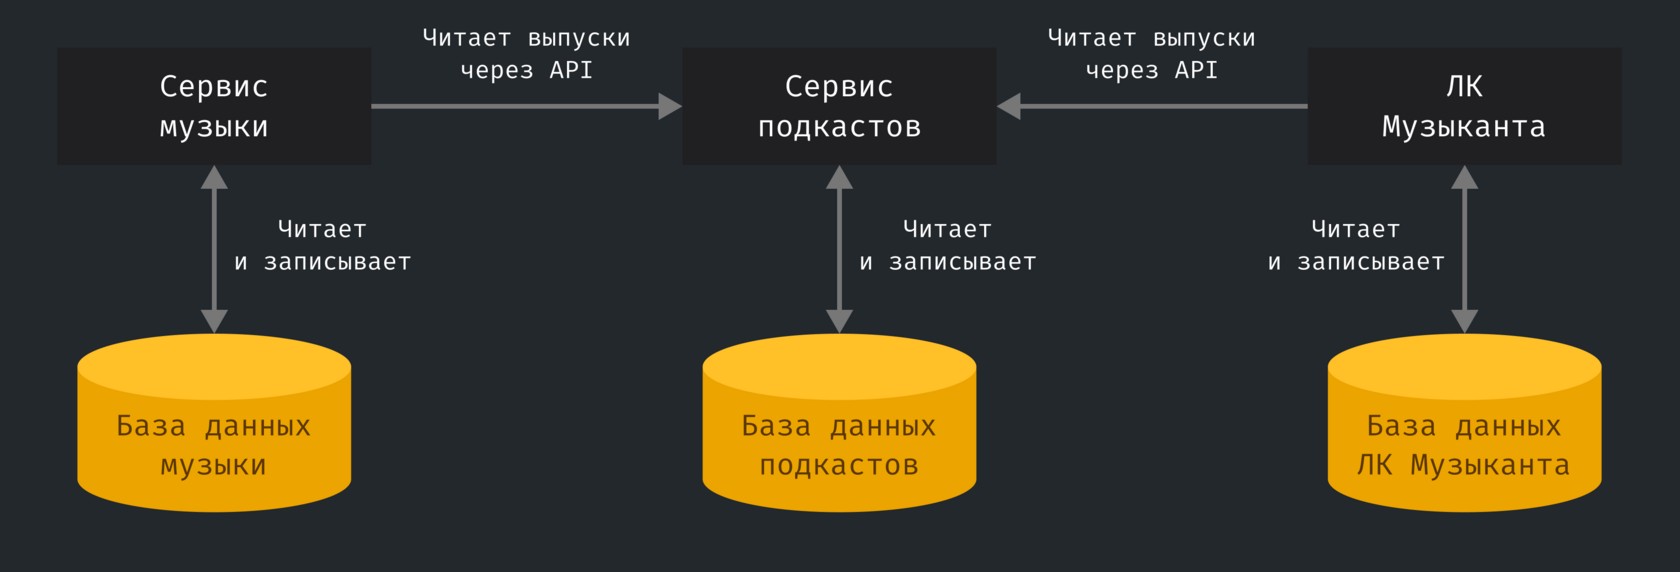
Отдельный сервер для каждой базы не обязателен: базы могут находиться в одном кластере PostgreSQL с разграничением прав, а в облаке мы вообще можем не знать их физическое расположение. За независимость мы платим более сложной работой с данными: привычный JOIN по общим таблицам заменяется обращениями к сервисам и сборкой результатов, приходится учитывать их недоступность и отдельно решать, как согласовывать изменения в нескольких базах.
ㅤ
4. Transactional Outbox — Не теряем события
С базами данных разобрались, но появилась новая проблема. Представим, что автор публикует новый выпуск подкаста: нам нужно сохранить его в базе данных сервиса подкастов, а также отправить событие в RabbitMQ или Kafka, чтобы сервис уведомлений рассказал подписчикам о новом выпуске. Казалось бы, что здесь сложного?
Но вот незадача: мы успешно сохранили подкаст в PostgreSQL, после чего сервис неожиданно упал, и сообщение в брокер так и не отправилось. Получается, подкаст опубликован, но подписчики о нём не узнают. Можно попробовать сделать наоборот: сначала отправить сообщение, а потом сохранить подкаст в базу. Но и здесь есть проблема: сообщение уже отправлено, а транзакция в базе данных по какой-то причине откатилась.
Разработчики со всего опенспейса еле как поместились в переговорку, долго обсуждали задачу и в итоге решили использовать паттерн Transactional Outbox. Вместо того чтобы сразу отправлять событие в брокер, мы сохраняем его в специальную таблицу outbox (назвать можно и по-другому, просто так вас лучше поймут другие разработчики) прямо в нашей базе данных. Причём делаем это в рамках одной транзакции с сохранением самого подкаста, поэтому либо сохранятся обе записи (подкаст + задача на уведомление), либо не сохранится ни одна.
Далее у нас работает специальный воркер, который раз в несколько секунд проверяет таблицу outbox, забирает оттуда новые события и отправляет их в брокер сообщений. Если брокер недоступен или произошла какая-то ошибка, событие никуда не пропадает, а остаётся в базе данных для следующей попытки. То есть мы добились как минимум exactly-once доставки сообщений! Это маленькая победа нашей большой команды!
Причём вместо периодического опроса таблицы можно использовать паттерн CDC — механизм отслеживания изменений базы данных, но об этом поговорим как-нибудь в следующий раз.
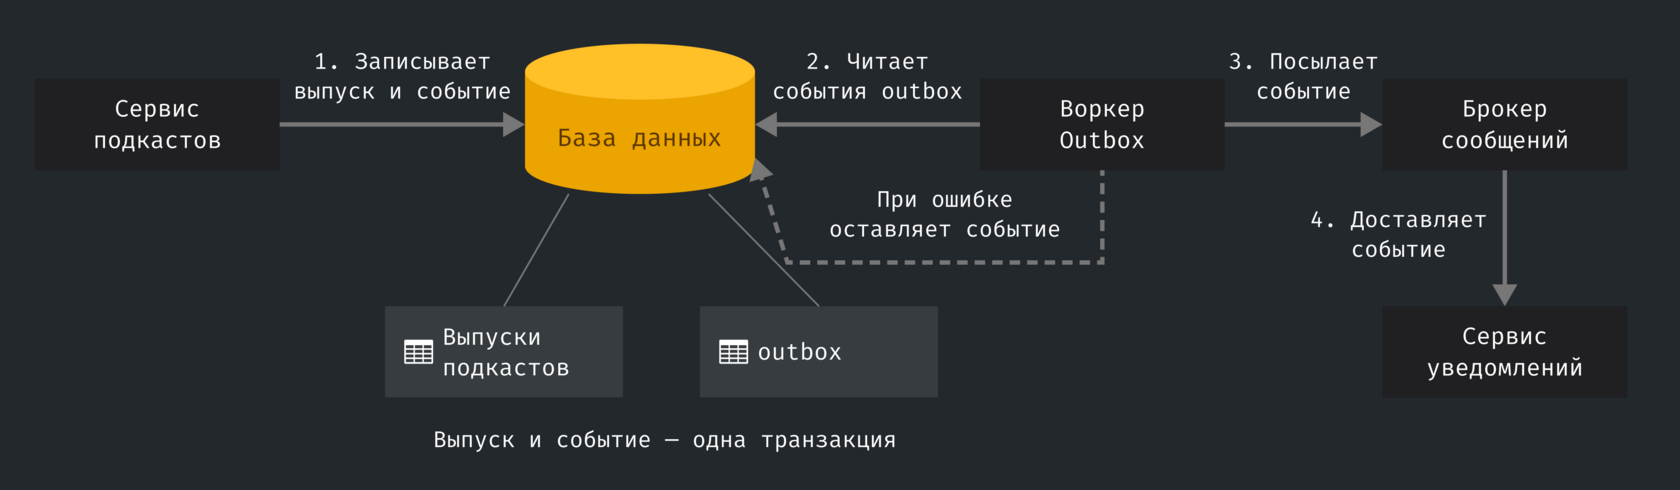
Правда, здесь появляется другой нюанс: представьте, что воркер успешно отправил сообщение в брокера, но упал до того, как отметил его отправленным. После восстановления он может отправить это же сообщение ещё раз, поэтому паттерн Outbox не гарантирует доставку ровно один раз. Кроме того, он не обеспечивает распределённую транзакцию между всеми микросервисами, а только связывает изменение данных с сохранением события внутри одной базы. И если потеря какого-то события для нас некритична, например это необязательная аналитика, отдельный Outbox может вообще не понадобиться.
ㅤ
5. Idempotent Consumer — Защищаемся от повторной обработки
Как мы только что выяснили, наш Transactional Outbox может отправить одно и то же сообщение несколько раз. Причём повторная доставка возможна и без аутбокса: например, сервис уведомлений успешно отправил уведомление пользователю о новом подкасте, но упал до того, как подтвердил брокеру получение сообщения. В итоге брокер решит, что сообщение не было обработано, и отправит его повторно.
Для пользователя это может обернуться двумя одинаковыми уведомлениями о новом подкасте, а если речь идёт об обработке событий оплаты, последствия могут быть гораздо неприятнее.
Наша команда как раз начала сталкиваться с подобными ошибками: то кому-то 3 раза пришло одно и то же уведомление, то оплата списалась 2 раза вместо одного. Причем любопытно, что эти ошибки происходили часто при падении или перезагрузке приложения — и команда долго не могла понять что не так. Поспрашивав гугл и нейронки, команда отыскала паттерн под названием Idempotent Consumer, или идемпотентный потребитель. Суть довольно простая: повторная обработка одного и того же сообщения не должна приводить к повторному выполнению бизнес-операции. То есть не должно быть ни двух одинаковых уведомлений, ни двух одинаковых платежей.
Как это реализовать? Ещё на стороне отправителя, в нашем случае сервиса подкастов, мы создаём для каждого события уникальный идентификатор, например в формате UUID. Если событие будет отправлено повторно, его идентификатор останется прежним, а сервис уведомлений сможет проверить, не получал ли он уже такую задачку. Для этого он хранит идентификаторы обработанных сообщений, например в специальной таблице inbox, и при повторном получении просто пропускает обработку. Причём проверку и сохранение идентификатора нужно реализовать так, чтобы два параллельных обработчика не могли одновременно принять одно сообщение за новое.
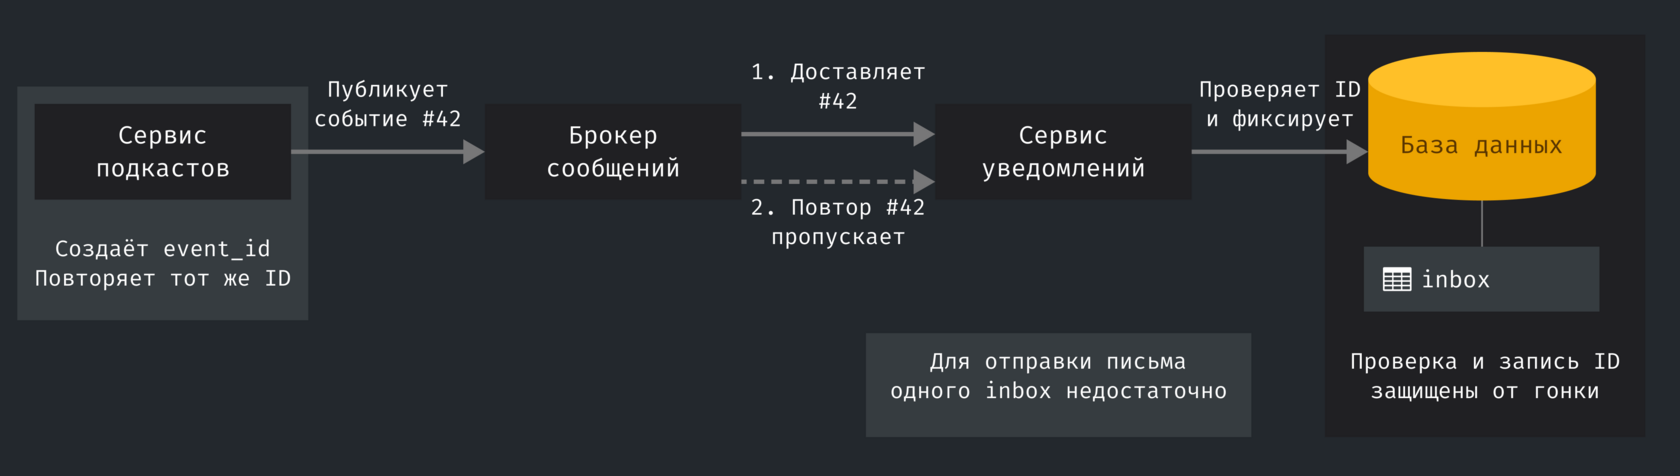
Почему вообще возникает такая проблема? Дело в том, что в распределённых системах довольно сложно обеспечить так называемый Exactly-Once, когда сообщение гарантированно обрабатывается ровно один раз. Гораздо проще организовать повторную доставку сообщений и сделать их обработку идемпотентной. Правда, если в ходе обработки мы выполняем внешнее действие, например отправляем письмо, одного inbox может оказаться недостаточно для полного исключения дублей.
При этом важно понимать, что отдельный Inbox нужен далеко не всегда. Например, если мы просто устанавливаем пользователю статус active = true, повторное выполнение такой операции ничего не изменит. А вот если при каждом получении события мы увеличиваем баланс пользователя на 100 рублей, повторная обработка уже приведёт к ошибке. Поэтому стоит смотреть на конкретную бизнес-логику и понимать, насколько опасны для нас повторные операции.
При этом важно понимать, что отдельный Inbox нужен далеко не всегда. Например, если мы просто устанавливаем пользователю статус active = true, повторное выполнение такой операции ничего не изменит. А вот если при каждом получении события мы увеличиваем баланс пользователя на 100 рублей, повторная обработка уже приведёт к ошибке. Поэтому стоит смотреть на конкретную бизнес-логику и понимать, насколько опасны для нас повторные операции.
ㅤ
6. Saga — Распределённые транзакции
Следующий паттерн — Saga. И здесь мы вернёмся к проблеме, которая возникла у нас после внедрения Database per Service.
Представьте, что мы хотим сделать обычную транзакцию в PostgreSQL, внутри которой изменяются данные сразу в нескольких таблицах. Это довольно простая история: начинаем транзакцию, выполняем несколько запросов и, если что-то пошло не так, откатываем изменения через ROLLBACK. Но теперь представьте, что эти таблицы находятся в разных базах данных, принадлежащих разным микросервисам. Как мы обсуждали ранее, напрямую обращаться к чужим базам мы не должны, а обычная транзакция PostgreSQL не позволяет просто объединить произвольные операции нескольких независимых сервисов в один BEGIN и COMMIT.
И здесь на помощь приходит Saga, которая позволяет согласовывать изменения сразу в нескольких микросервисах. Вместо одной большой транзакции мы выполняем несколько небольших, причём каждая из них происходит внутри своего сервиса. Если на каком-то этапе возникает ошибка, мы можем выполнить компенсирующие операции, которые исправят последствия предыдущих действий. То есть это чем-то напоминает обычный ROLLBACK, просто теперь нам приходится самостоятельно продумывать, как отменять изменения.
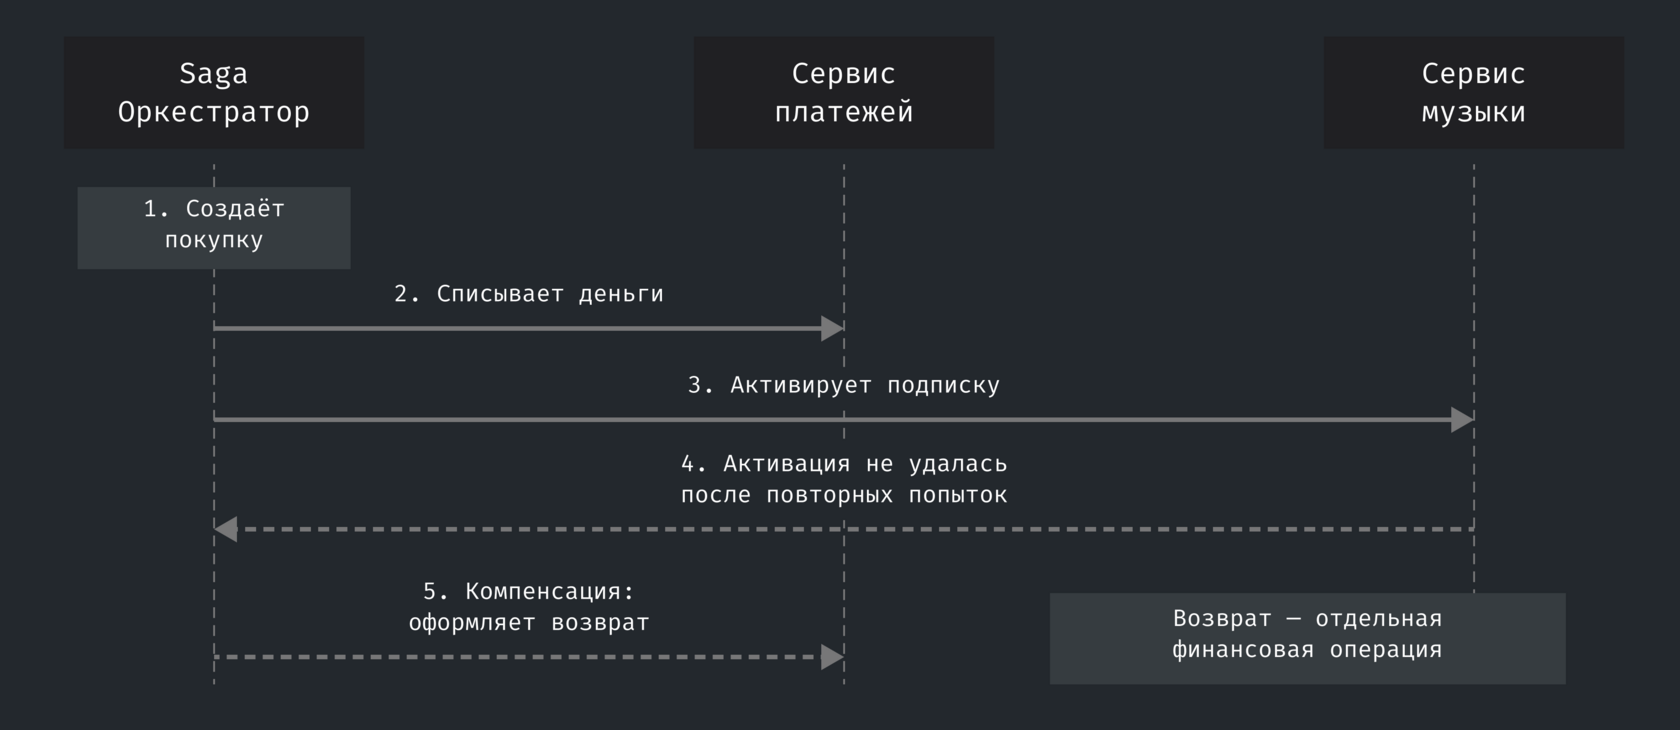
Давайте рассмотрим пример с нашей Пай.Музыкой. Пользователь решил оформить платную подписку, для чего нам нужно списать с него деньги через сервис платежей и активировать доступ в сервисе музыки. Представим, что первый шаг прошёл успешно и деньги списались, но после этого сервис музыки оказался недоступен и даже после повторных попыток так и не смог активировать подписку. Получается крайне неприятная ситуация: пользователь заплатил, а доступ к музыке не получил.
Поэтому мы организуем Сагу следующим образом: сначала создаём покупку, затем просим сервис платежей списать деньги и после успешной оплаты активируем подписку. Если все операции выполнены, отлично, считаем покупку завершённой. А если активировать подписку окончательно не удалось, запускаем компенсирующую операцию — обращаемся к сервису платежей и оформляем возврат денег. Причём важно понимать, что возврат будет отдельной финансовой операцией, а не буквальным откатом предыдущей транзакции. В логике компенсаций часто кроется сложность внеднерия Саги в проект.
Управлять этой последовательностью можно через отдельный компонент, который будет обращаться к сервисам и контролировать выполнение каждого шага. Такой подход называют оркестрацией. Есть и другой вариант — хореография, когда сервисы самостоятельно реагируют на события друг друга и запускают следующие операции. При этом Сага вполне может использовать Transactional Outbox для надёжной отправки событий между участниками. Обратите внимание, как Transactional outbox помогает нам решать проблемы в других паттернах.
Конечно, за такую функциональность приходится платить дополнительной сложностью. Нам нужно хранить состояние процесса, учитывать таймауты, повторные запросы и продумывать компенсирующие действия, которые тоже могут завершиться ошибкой. Поэтому если у нас нет бизнес-процессов, требующих согласованных изменений в нескольких сервисах, внедрять паттерн Saga, скорее всего, незачем.
ㅤ
7. Circuit Breaker — Защищаемся от отказов сервисов
И последний паттерн, который мы сегодня разберём, — Circuit Breaker.
Давайте представим, что на главной странице Пай.Музыки показываются не только музыкальные треки, но и подборка подкастов, которые могут понравиться пользователю. Для этого основной сервис музыки обращается к сервису подкастов и получает оттуда необходимые данные. Всё прекрасно работает до тех пор, пока сервис подкастов не начинает тормозить или вообще перестаёт отвечать.
Например, раньше он обрабатывал запросы за 100 миллисекунд, а теперь каждый запрос выполняется по 10 секунд. Наш сервис музыки по-прежнему пытается обратиться к нему, ожидает ответы, накапливает большое количество запросов и расходует свои ресурсы. В результате может получиться так, что из-за одного неработающего сервиса подкастов у нас начнёт тормозить вообще всё приложение. Хотя, казалось бы, пользователь вполне мог бы слушать музыку и без подборки подкастов.
И вот здесь нам помогает Circuit Breaker, который позволяет временно прекращать обращения к проблемному сервису. Например, если за определённый промежуток времени сервис подкастов пять раз не ответил, Circuit Breaker может решить, что сервис сейчас недоступен, и на некоторое время перестать отправлять ему запросы. Причём вместо того, чтобы каждый раз ждать по 10 секунд, мы можем сразу возвращать запасной результат — например, просто не показывать блок с подкастами на главной странице.
Но ведь нам нужно как-то понять, когда сервис восстановится? Поэтому спустя некоторое время Circuit Breaker пропускает несколько пробных запросов, чтобы проверить, нормально ли работает сервис подкастов. Если всё хорошо, возвращаемся к обычному режиму, а если ошибки продолжаются, опять временно прекращаем обращения. Для этого Circuit Breaker использует три состояния: Closed — запросы проходят в обычном режиме, Open — обращения блокируются, Half-Open — проверяем, восстановился ли сервис.
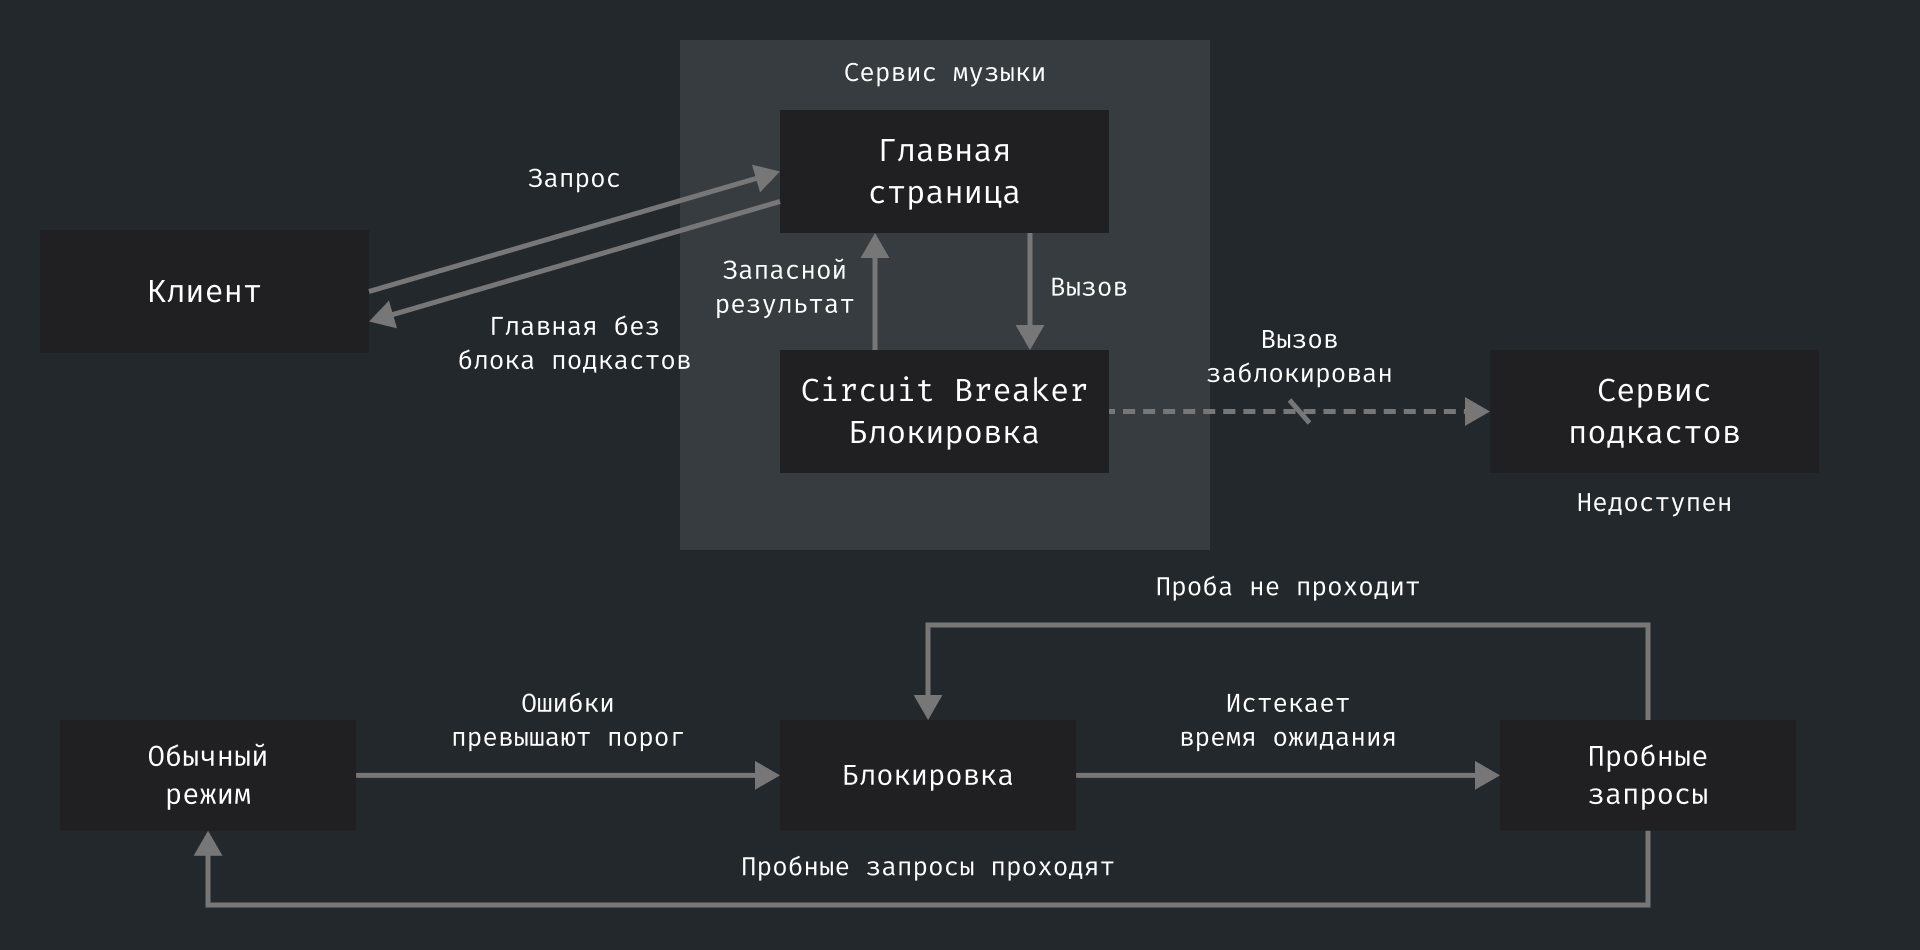
Таким образом, мы защищаем основной сервис музыки от накопления запросов и даём сервису подкастов возможность восстановиться без дополнительного потока обращений. Правда, Circuit Breaker не заменяет обычные таймауты, а неправильно настроенные условия срабатывания могут привести к тому, что мы начнём блокировать даже вполне работоспособный сервис. Кроме того, не для каждой операции существует хороший запасной сценарий: если недоступен сервис платежей, просто сделать вид, что оплата прошла успешно, конечно же, нельзя.
Поэтому Circuit Breaker полезен там, где отказ одного сервиса способен потянуть за собой остальные. Но если у нас небольшая система, в которой подобных проблем пока не возникает, внедрение такого механизма может оказаться избыточным.
Поэтому Circuit Breaker полезен там, где отказ одного сервиса способен потянуть за собой остальные. Но если у нас небольшая система, в которой подобных проблем пока не возникает, внедрение такого механизма может оказаться избыточным.


© 2025 ИП Шумейко Артём Владимирович
ИНН 110103208338 ОГРНИП 323784700281112